0题目原文(本地存了一份)
原题在洛谷上(页头有链接)。别人的网站不归我们管,打不开、改版、题号调整都可能发生。 所以每个解析页都把题面转录一份存在本地,跟着仓库一起进版本库。
转录自洛谷 P3374,日期见页头。两边不一致时信原站。
题目描述
如题,已知一个数列,你需要进行下面两种操作:
-
将某一个数加上
x; -
求出某区间每一个数的和。
输入格式
第一行包含两个正整数 n、m,分别表示该数列数字的个数和操作的总个数。
第二行包含 n 个用空格分隔的整数,其中第 i 个数字表示数列第 i 项的初始值。
接下来 m 行每行包含 3 个整数,表示一个操作,具体如下:
-
1 x k含义:将第x个数加上k; -
2 x y含义:输出区间[x, y]内每个数的和。
输出格式
输出包含若干行整数,即为所有操作 2 的结果。
数据范围
对于 30% 的数据,1 ≤ n ≤ 8,1 ≤ m ≤ 10;
对于 70% 的数据,1 ≤ n, m ≤ 10⁴;
对于 100% 的数据,1 ≤ n, m ≤ 5 × 10⁵,1 ≤ x ≤ y ≤ n,−2³¹ ≤ k < 2³¹。
★ 数据保证对于任意时刻,a 的任意子区间(包括长度为 1 和 n 的子区间)和均在 [−2³¹, 2³¹) 范围内。
时限 1 秒,内存 512 MB。
输入输出样例
输入
5 5
1 5 4 2 3
1 1 3
2 2 5
1 3 -1
1 4 2
2 1 4
输出
14
16
★ 样例说明(下面这张表转录自原站,见图):初始数列 1 5 4 2 3,
1 1 3 把第 1 个数加 3 ⇒ 4 5 4 2 3,于是 2 2 5 问的是 5+4+2+3 = 14;
接着 1 3 -1、1 4 2 ⇒ 4 5 3 4 3,2 1 4 是 4+5+3+4 = 16。
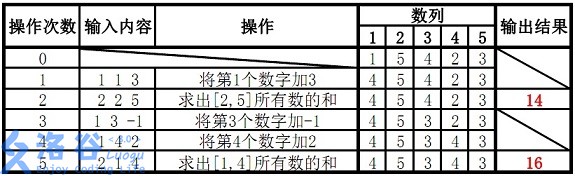
这道题考什么:把第 x 个数加 k,以及问区间 [x, y] 的和。这道题就是第 38 章本章正文那道题,去掉最后一问,lowbit(i) = i & -i、c[i] 只攒 lowbit(i) 那么长的一段 —— 别的一个字都不差。
最容易错的三处
- 区间和写成
sum(y) − sum(x):它算的是[x+1, y]的和,恒少一个a[x](官方样例第一问正解 14、它打出 9)。 - 整棵树用
int:这道题上它一次都不会错,但有符号溢出是 UB ⇒ 正解里仍然写long long(代价是零)。 - 读入:顶格要读 2 × 10⁶ 个整数,默认
cin要 245 毫秒 —— 读入是算法的 10 倍。
能 AC 的:p3374.cpp(第 ② 步),顶格端到端 0.11 秒 / 时限 1 秒;p3374Seg.cpp(第 ④ 步,线段树版)也标着 ★。
下面每一步里灰色的「深入」块是折叠的:那是这些结论怎么实测出来的,第一遍可以跳过。
1两个暴力 —— 而它们正好是一对反面
这道题只有两种操作,每一种单独看都有 O(1) 的做法:
// P3374 第 ① 版:**题目怎么说就怎么做** —— 改是 O(1),查是 O(区间长度)//// ★ 它值多少分,题面自己写着(读数据范围的时候顺手把它乘出来)://     · 「对于 30% 的数据,1 ≤ n ≤ 8,1 ≤ m ≤ 10」  ⇒ 80 次加法,★ 稳拿 30 分;//     · 「对于 70% 的数据,1 ≤ n, m ≤ 10⁴」        ⇒ 10⁸ 次,本机约 0.05 秒 ⇒ ★ 也过得去;//     · 顶格 n = m = 5×10⁵                        ⇒ **2.5×10¹¹ 次**,一秒的时限差着四个数量级。//// ⇒ 所以这一版不是「白写的」:它是 70 分,而且它是后面所有版本的**参照物**(对拍拿它当标准答案)。
#include <bits/stdc++.h>using namespace std;
int main() {    ios::sync_with_stdio(false);    cin.tie(nullptr);
    int n, m;    if (!(cin >> n >> m)) return 0;    vector<long long> a(n + 1, 0);    for (int i = 1; i <= n; i++) cin >> a[i];
string out; for (int q = 0; q < m; q++) { int op; cin >> op; if (op == 1) { int x; long long k; cin >> x >> k; a[x] += k; // ★ 改:O(1) } else { int x, y; cin >> x >> y; long long s = 0; for (int i = x; i <= y; i++) s += a[i]; // ⚠ 查:一个一个加,O(y − x + 1) out += to_string(s); out += '\n'; } } cout << out; return 0;}点「运行 ▶」看结果
| 改一个数 | 查一段和 | 顶格 n = m = 5 × 10⁵,各自最坏的配比 |
|
|---|---|---|---|
| ① 直接存数组 | ★ O(1) | ⚠ O(区间长度) | 全是「问整段」⇒ 2.5 × 10¹¹ 次 |
| ② 前缀和(第 6 章) | ⚠ O(n) | ★ O(1) | 全是「改第 1 个」⇒ 2.5 × 10¹¹ 次 |
| ★ ③ 树状数组 | O(log n) | O(log n) | 怎么配都是约 2 × 10⁷ 次 |
★ 第三行那句「怎么配都」才是重点:前两行各有一个自己扛得住的配比, 而这道题的操作是混着给的(下面那张秒表是「改查各半」量的)。
深入:三个版本在顶格上的秒表(进阶)
本机实测(A 机 · WSL2 · Linux 6.18 / 8 线程 / 7 GB,2026-08-31,独占;
p3374Count.cpp 在进程内用 steady_clock 量,不含读入):
n = m |
① 一个一个加 | ② 前缀和 | ★ ③ 树状数组 |
|---|---|---|---|
| 10⁴(题面 70% 那一档) | 4 ms | 4 ms | ★ 0 ms |
| 10⁵ | 403 ms | 478 ms | ★ 3 ms |
| 5 × 10⁵(顶格) | 按 n·m 外推约 10 秒 |
约 12 秒 | ★ 25 ms |
★ 所以第 ① 版不是白写的:题面「70% 的数据 n, m ≤ 10⁴」那一档它 4 毫秒就跑完了
⇒ 考场上是实打实的 70 分,而且它是后面所有版本的参照物(对拍拿它当标准答案)。
2★ 正解:把两个 O(1) 换成两个 O(log n)
// P3374【模板】树状数组 1 —— ★ 这一版就能 AC(单点加 + 区间和)//// 和本章正文那道题(fast.cpp)**几乎是同一份代码**,差别只有两处://   ① 正文那道题末尾多问一句「整个数组的和」,这道题没有;//   ② ★★ 题面的那句保证不一样 —— 而那句话正好是本页最值钱的东西(见下)。//// ============ ★★★ 题面替你把「要不要 long long」这笔账付了 ============////   题面最后一行:**「数据保证对于任意时刻,a 的任意子区间(包括长度为 1 和 n//   的子区间)和均在 [−2³¹, 2³¹) 范围内。」**////   ⇒ 那个区间**逐字就是 int 的范围**(−2 147 483 648 … 2 147 483 647)。//   ⇒ 而它保证的不只是「答案」://        · c[i] = a[i−lowbit(i)+1] + … + a[i]  —— **本身就是一个子区间和** ⇒ 在范围内;//        · sum(r) 一路累加,每一步的部分和是 (j, r] 这一段的和 —— **也是子区间和** ⇒ 在范围内;//        · 答案 sum(r) − sum(l−1) = [l, r] 的和 —— 还是子区间和。//     ⇒ **整棵树、每一个中间值,全在 int 里。**(p3374Count.cpp 在两个档上量过最大绝对值。)////   ⚠ 但这里仍然写 long long:**因为那句保证一旦被拿掉,int 立刻就错**//     (生成器档 2 专门造违反它的数据,int 版 300 / 300 全错)——//     ⇒ 这一页的结论不是「用 int」,是**「这道题能用 int,而这是题面给的,不是算法给的」**。//// 复杂度 O((n + m) log n):顶格 n = m = 5×10⁵ ⇒ 约 2×10⁷ 次基本操作。
#include <bits/stdc++.h>using namespace std;
const int MAXN = 500005;long long c[MAXN];int n, m;
inline int lowbit(int i) { return i & -i; }
void add(int p, long long x) {    for (int i = p; i <= n; i += lowbit(i)) c[i] += x;}
long long sum(int r) {    long long s = 0;    for (int i = r; i > 0; i -= lowbit(i)) s += c[i];    return s;}
int main() {    ios::sync_with_stdio(false);          // ★ 这一句在这道题上值 4.7 倍(245 → 52 毫秒),见第 ⑤ 步    cin.tie(nullptr);
    if (!(cin >> n >> m)) return 0;
    // ★ O(n) 建树:a[i] 先落进 c[i],再把 c[i] 整个交给它爸爸 i + lowbit(i)    for (int i = 1; i <= n; i++) {        long long x;        cin >> x;        c[i] += x;        int f = i + lowbit(i);        if (f <= n) c[f] += c[i];    }
string out; for (int q = 0; q < m; q++) { int op; cin >> op; if (op == 1) { int x; long long k; cin >> x >> k; add(x, k); } else { int x, y; cin >> x >> y; out += to_string(sum(y) - sum(x - 1)); // ⚠ 是 x−1 out += '\n'; } } cout << out; return 0;}点「运行 ▶」看结果
第 38 章从头到尾讲的就是它:lowbit(i) = i & -i、
c[i] 只攒 lowbit(i) 那么长的一段、改和查各走一条 O(log n) 的路。
正文那道题在末尾多问了一句「整个数组的和」(那一句专门用来抓「add 写成 i < n」),
这道题没有 —— 别的一个字都不差。
⇒ 所以这一页不重复讲算法,只讲这道题自己的三件事:
第 ③ 步那个几乎人人都会写错一次的 −1、第 ④ 步题面替你付掉的那笔账、第 ⑤ 步的读入。
3✗ 第一个坑:区间和写成 sum(y) − sum(x)
它算的是 [x+1, y] 的和 —— 不是「错了」,是恒等于另一个量:
正解 − 它 = a[x]⇒ 于是不用跑就知道:
a[x] = 0的时候它一个字都不错 —— ⚠ 而「初始数组全是 0」正是最顺手的生成器写法(本章第 ⑫ 步那条「顺手写法」);x = y的时候它恒输出 0;- 官方样例第一问
2 2 5:正解 14,它打出 9(= 14 −a[2]= 14 − 5)⇒ 样例挡住了它。
深入:四个档各 300 轮的实测(进阶)
★ 实测四个档各 300 轮:300 / 298 / 298 / 297 —— 它几乎躲不掉,
因为「a[x] ≠ 0」这个条件在任何有初值的数据上都近乎必然成立。
4★★★ 题面最后那一行,替你把「要不要 long long」这笔账付了
题面:「数据保证对于任意时刻,a 的任意子区间(包括长度为 1 和 n 的子区间)和均在 [−2³¹, 2³¹) 范围内。」
★ 第一件事是逐字对一遍:[−2³¹, 2³¹) = [−2147483648, 2147483647] ——
这就是 int 的范围,一个数都不多一个数都不少。
★★ 第二件事才是关键:它保证的不只是答案。树状数组里出现的每一个数都是某个子区间的和:
| 出现在哪儿 | 它是哪一段的和 |
|---|---|
c[i] |
(i − lowbit(i), i] ⇒ 子区间和 ✓ |
sum(r) 累加途中的部分和 |
(j, r](j 是当前走到的下标)⇒ 子区间和 ✓ |
答案 sum(y) − sum(x−1) |
[x, y] ⇒ 子区间和 ✓ |
⇒ 整棵树、每一个中间值,全在 int 里。
实测(档 1,值域拉到守着那句保证的边上,300 轮):
max|c[i]| = 374 381 420、max|部分和| = 337 217 021,都在 2³¹ 以内。
⇒ 所以 p3374Int.cpp(整棵树用 int)在这道题上一次都不会错 ——
对拍档 0 / 档 1 / 档 3 各 300 轮,0 次不一致。
深入:违反那句保证时,int 版错在哪一轮(进阶)
造一档违反那句保证的数据(档 2:值域 ±10⁹、n 只有十来个 ⇒ 子区间和可达 1.2 × 10¹⁰),
int 版当场就现形。⚠ 但被抓的轮数比我草稿里写的少得多,而少下来的部分正好能说清楚:
| 档 2,300 轮 | 轮数 |
|---|---|
① 某一时刻真的存在越出 int 的子区间和 |
211 |
② 被问到的那个区间的答案越出 int |
★ 65 |
③ int 版真被抓 |
★ 65 —— ⚠ 和 ② 一个不差 |
★★★ ②≡③ 是能证的,而且它解释了为什么不是 211:
int 的加减是模 2³² 同余的(补码),所以只要答案本身装得进 int,
中间怎么绕都会绕回同一个数 ⇒ 中间值溢出 ≠ 答案错。
⇒ 这一页因此得到一句可以到处用的话:
「它溢出了」和「它算错了」是两件事,中间隔着一句「答案本身装不装得下」。
⚠ 但结论不是「所以可以写 int」:有符号溢出是 UB,
它这次绕回来是编译器按补码办事的结果,标准一个字都没保证。
⇒ 正解里仍然写 long long:代价是零,而它让这一页的推理整段都不必要。
5⚠ 这道题真正花时间的地方不是算法,是读入
深入:读入那笔账,以及三道题排成的那条线(进阶)
先把账乘出来(三十秒的算术):
n, m ≤ 5×10⁵ ⇒ 要读 5×10⁵ + 3×5×10⁵ = 2×10⁶ 个整数
实测顶格那份输入 9 376 421 字节(8.94 MB),输出 1 733 736 字节本机实测(同机同日独占,p3374Count.cpp 在进程内 freopen 同一份文件读两遍):
| 读 2 × 10⁶ 个整数 | 毫秒 |
|---|---|
cin(默认,同步开着) |
245 |
cin + ios::sync_with_stdio(false) |
★ 52 |
⇒ 而整个树状数组算法只要 25 毫秒 —— ★ 读入是算法的 10 倍。 ⇒ 两种读法在 1 秒的时限里都过得去(端到端 0.11 秒), 但「这道题快在哪儿」的答案是:它根本不在算法上。
★ 和前面两页对一下,三道题正好排成一条线(倍数跨题几乎不变,变的是绝对时间):
| 要读多少个数 | 时限 | 结论 | |
|---|---|---|---|
| 第 6 章 P2367 | 2 × 10⁷ | 1 秒 | ⚠ 连 scanf 都不够,只有快读过 |
| 第 19 章 P1803 | 2 × 10⁶ | 3 秒 | ★ 四种读法全都够 |
| ★ 这道题 | 2 × 10⁶ | 1 秒 | 都够,但不关同步就花掉四分之一的时限 |
6★ 对拍:四个档位各 300 轮
深入:对拍档位表与档 1 那两个 0(进阶)
| 300 轮 | ① 一个一个加 | ② 前缀和 | ✗ 少减 1 | ★ 整棵树用 int |
|---|---|---|---|---|
| 档 0:顺手(初值 1~100 全正) | 0 | 0 | 300 | 0 |
| 档 1:大值域,守住题面那句保证 | 0 | 0 | 298 | ★ 0 |
| ⚠ 档 2:故意违反那句保证 | 0 | 0 | 298 | ★ 65 |
档 3:查询端点专挑 x=1 / y=n / x=y |
0 | 0 | 297 | 0 |
★ 档 1 那两个 0 是分两步交代的(不然它和「这段代码没在跑」长得一样):
① 度量程序在同一档上数了一遍「真的越界的轮数」,是 0 / 300
⇒ int 版不出错,是因为那一档根本没越界;
② 而「这段代码确实在跑」由档 2 的 65 保证 —— 同一份 p3374Int.cpp,换一档就被抓了。
(报「精确的 0」之前先拿一个已知错的东西验一遍,这是第 N 次。)
8★★ 补一节(2026-09-01):这道题在第 39 章的题单里又出现了一次
这一页原来只讲树状数组那条线。而第 39 章(线段树)的题单又列了这道题, 要求是:「第 38 章交过的那道,这次用线段树再交一遍。 本章第 13 步已经把两份代码摆在一起了,但亲手交两遍才有体感: 行数、耗时、以及哪一份改成区间最值只要动两处。」
⇒ 于是同一道题有了两份正解,可以真的称一称。
// P3374 第 ④ 版:**线段树**([第 39 章](/ch/39-segment-tree/)那把锤子)//// ★ 这一节是 2026-09-01 补的:这道题在**第 39 章的题单里又出现了一次**,//   而那一章的要求是「第 38 章交过的那道,这次用线段树再交一遍」。//   ⇒ 于是同一道题有了两份正解,可以把它们并排称一称:行数、耗时、以及「改成别的问题要动几处」。//// ⚠ 和第 39 章正文里那份 single.cpp 的唯一差别:**这一份不打末尾那一行**。//   (第 39 章为了教学,在第 38 章那道题上多问了一行「整个数组的和」;**真题不要**。)//// ★ 单点改是「区间加」的特例(l = r)⇒ 这道题**用不着懒标记**://   一路递归到那个叶子改掉,回溯时 pushup。没有 lz、没有 pushdown、没有「乘区间长度」。//// 复杂度:建树 O(n),每次操作 O(log n) —— 和树状数组同级,差别全在常数和代码量上。
#include <bits/stdc++.h>using namespace std;
const int MAXN = 500005;long long sm[MAXN * 4];long long a[MAXN];int n, m;
void build(int o, int l, int r) {    if (l == r) { sm[o] = a[l]; return; }    int mid = (l + r) / 2;    build(o * 2, l, mid);    build(o * 2 + 1, mid + 1, r);    sm[o] = sm[o * 2] + sm[o * 2 + 1];}
void add(int o, int l, int r, int p, long long x) {    if (l == r) { sm[o] += x; return; }    int mid = (l + r) / 2;    if (p <= mid) add(o * 2, l, mid, p, x);    else add(o * 2 + 1, mid + 1, r, p, x);    sm[o] = sm[o * 2] + sm[o * 2 + 1];}
long long query(int o, int l, int r, int ql, int qr) {    if (ql <= l && r <= qr) return sm[o];    int mid = (l + r) / 2;    long long s = 0;    if (ql <= mid) s += query(o * 2, l, mid, ql, qr);    if (qr > mid) s += query(o * 2 + 1, mid + 1, r, ql, qr);    return s;}
int main() {    ios::sync_with_stdio(false);    cin.tie(nullptr);
    if (!(cin >> n >> m)) return 0;    for (int i = 1; i <= n; i++) cin >> a[i];    build(1, 1, n);
string out; for (int q = 0; q < m; q++) { int op; cin >> op; if (op == 1) { int x; long long k; cin >> x >> k; add(1, 1, n, x, k); } else { int x, y; cin >> x >> y; out += to_string(query(1, 1, n, x, y)); out += '\n'; } } cout << out; return 0;}点「运行 ▶」看结果
深入:树状数组版与线段树版并排称一称(进阶)
本机实测(A 机 · WSL2 · Linux 6.18 / 8 线程 / 7 GB,2026-09-01,独占;
p3374SegCount.cpp 在进程内用 steady_clock 量,不含读入):
| 树状数组 | 线段树 | 比 | |
|---|---|---|---|
| 非空非注释行数 | 43 | 52 | 1.21 倍 |
| 顶格算法耗时 | ★ 30 ms | 224 ms | ★ 7.46 倍 |
| 碰的节点数 | 770 万 | 1870 万 | 2.43 倍 |
| 数组占用 | ★ 3 MB(n+1 个 long long) |
15 MB(4n) |
5 倍 |
| 300 轮 × 三档对拍 | —— | —— | ★ 逐字节相同 |
★★★ 而这里有一个不量就会得出相反结论的地方: 端到端(含读入)是 92 ms vs 231 ms,只差 2.5 倍; 把那 9.4 MB 读入的时间减掉,才是 7.46 倍。 ⇒ 这正是第 34 章 P3366 那条:那张表如果不量「只读入」那一列,会得出完全错误的结论。
★ 两把尺子这次不打架但差着量级:碰的节点数只差 2.43 倍,秒表差 7.46 倍 ——
差在树状数组是一个平的 for 循环(i += i & -i,连续内存),线段树是递归。
(同一天在第 39 章 P1531 上量到的是反过来的一次:
树状数组那条路复杂度更差 O(log²n)、步数多 1.59 倍,秒表却快 2.5 倍 —— 同样是这个原因。)
把这道题从「区间和」改成「区间最大值」:
| 要改哪几处 | 结果 | |
|---|---|---|
| ★ 线段树 | ① pushup 那一行换成 max;② 「乘区间长度」那一项自然消失 |
★ 两处,照样 O(log n) |
| ⚠ 树状数组 | sum(r) − sum(l−1) 这个套路整个塌掉 —— 最大值没有减法 |
⚠ 见下 |
⇒ 这就是第 39 章第 13 步那句「不是线段树更快,是它能干的事多」的实测版。
⚠⚠ 但那句话也要补一个主语,而补法在第 39 章 P1531 那一页: 如果题面保证「每个位置只增不减」,树状数组照样能求区间最值(O(log²n))—— 那道题的「成绩低于 b 才改」正是这样一张许可证。 ⇒ ★★ 「树状数组做不到区间最值」少的主语是「任意的单点改」。
// P3374 补的那一节用的度量程序:./p3374SegCount csv////   ms    : 顶格 n = m = 5×10⁵ 上,**同一批操作**分别喂给树状数组和线段树,//           在进程内用 steady_clock 量(**不含读入** —— 这道题读入 245 毫秒,//           不减掉它,两种做法的差别会被整个吃掉,见[第 34 章 P3366](/sol/p3366/) 那条)。//   steps : 换一把机器无关的尺子 —— 两边各「碰了多少个节点」。//   same  : 两种做法逐个答案相同。//// ⚠ 这里**复刻**了 p3374Gen.cpp 档 4 的逻辑(同一个 mt19937、同一个种子公式)。
#include <bits/stdc++.h>#include <chrono>using namespace std;using namespace std::chrono;
struct Op { int type, x, y; long long k; };
int n, m;static long long steps;
/* ---- 树状数组 ---- */static vector<long long> c;static inline int lowbit(int x) { return x & -x; }static void bAdd(int i, long long v) { for (; i <= n; i += lowbit(i)) { c[i] += v; steps++; } }static long long bSum(int i) { long long s = 0; for (; i > 0; i -= lowbit(i)) { s += c[i]; steps++; } return s; }
/* ---- 线段树 ---- */static vector<long long> sm;static void build(int o, int l, int r, const vector<long long>& a) {    steps++;    if (l == r) { sm[o] = a[l]; return; }    int mid = (l + r) / 2;    build(o * 2, l, mid, a); build(o * 2 + 1, mid + 1, r, a);    sm[o] = sm[o * 2] + sm[o * 2 + 1];}static void sAdd(int o, int l, int r, int p, long long x) {    steps++;    if (l == r) { sm[o] += x; return; }    int mid = (l + r) / 2;    if (p <= mid) sAdd(o * 2, l, mid, p, x); else sAdd(o * 2 + 1, mid + 1, r, p, x);    sm[o] = sm[o * 2] + sm[o * 2 + 1];}static long long sQry(int o, int l, int r, int ql, int qr) {    steps++;    if (ql <= l && r <= qr) return sm[o];    int mid = (l + r) / 2;    long long s = 0;    if (ql <= mid) s += sQry(o * 2, l, mid, ql, qr);    if (qr > mid) s += sQry(o * 2 + 1, mid + 1, r, ql, qr);    return s;}
int main(int argc, char** argv) {    bool csv = (argc > 1 && string(argv[1]) == "csv");
    // ⚠ 复刻 p3374Gen.cpp 的档 4    mt19937 rng(1u * 1000003u + 20260902u);    n = 500000; m = 500000;    long long hi = 1000;    vector<long long> a(n + 1);    for (int i = 1; i <= n; i++) { long long v = (long long)(rng() % (unsigned long long)(2 * hi + 1)) - hi; a[i] = v; }    vector<Op> ops;    for (int q = 0; q < m; q++) {        int x = 1 + (int)(rng() % (unsigned)n);        int y = 1 + (int)(rng() % (unsigned)n);        if (x > y) swap(x, y);        int op = 1 + (int)(rng() % 2u);        long long k = (long long)(rng() % (unsigned long long)(2 * hi + 1)) - hi;        ops.push_back({op, x, y, k});    }
    vector<long long> o1, o2;    c.assign(n + 2, 0);    steps = 0;    auto t0 = steady_clock::now();    for (int i = 1; i <= n; i++) { c[i] += a[i]; int f = i + lowbit(i); if (f <= n) c[f] += c[i]; steps++; }    for (const Op& o : ops) {        if (o.type == 1) bAdd(o.x, o.k);        else o1.push_back(bSum(o.y) - bSum(o.x - 1));    }    double msBit = duration<double, milli>(steady_clock::now() - t0).count();    long long stBit = steps;
    sm.assign((size_t)n * 4 + 4, 0);    steps = 0;    t0 = steady_clock::now();    build(1, 1, n, a);    for (const Op& o : ops) {        if (o.type == 1) sAdd(1, 1, n, o.x, o.k);        else o2.push_back(sQry(1, 1, n, o.x, o.y));    }    double msSeg = duration<double, milli>(steady_clock::now() - t0).count();    long long stSeg = steps;
    bool same = (o1 == o2);
if (csv) { printf("msBit,%.0f\nmsSeg,%.0f\n", msBit, msSeg); printf("stBit,%lld\nstSeg,%lld\n", stBit, stSeg); printf("same,%d\n", same ? 1 : 0); printf("ratioMs,%.2f\nratioSteps,%.2f\n", msSeg / max(0.001, msBit), (double)stSeg / stBit); printf("mem,%d\n", (int)((sm.size() * 8) / (1 << 20))); return 0; } printf("顶格 n = m = 5×10⁵(进程内计时,不含读入):\n\n"); printf(" 树状数组 %5.0f ms 碰了 %10lld 个节点 数组 %d MB\n", msBit, stBit, (int)((c.size() * 8) >> 20)); printf(" 线段树 %5.0f ms 碰了 %10lld 个节点 数组 %d MB\n", msSeg, stSeg, (int)((sm.size() * 8) >> 20)); printf("\n 秒表比 %.2f 倍,碰的节点数比 %.2f 倍;两边答案一致:%s\n", msSeg / max(0.001, msBit), (double)stSeg / stBit, same ? "是" : "★ 否"); return 0;}点「运行 ▶」看结果
9一页纸
| ★ 暴力值多少分 | 题面 70% 档 n, m ≤ 10⁴ ⇒ 4 毫秒,稳拿 70 分;顶格最坏 2.5 × 10¹¹ 次 |
| ★★ 关键一步 | 两个暴力各有一头是 O(1)、另一头是 O(n);树状数组把两头都换成 O(log n) |
| ⚠ 最容易写错的一处 | sum(y) − sum(x−1) 的那个 −1(写成 sum(x) ⇒ 恒少一个 a[x],300/298/298/297 被抓) |
| ★★★ 题面替你付的账 | 「任意子区间和 ∈ [−2³¹, 2³¹)」逐字就是 int 的范围,而 c[i] 和部分和都是子区间和 ⇒ 整棵树都在 int 里 |
| ★★★ 而它保的是哪一层 | 违反那句保证时:越界 211 轮,答案本身越界 65 轮,int 版被抓 65 轮(一个不差)—— 溢出 ≠ 答错,因为 int 的加减模 2³² 同余 |
| ⚠ 别学的地方 | 有符号溢出是 UB ⇒ 正解仍写 long long(代价是零) |
| ⚠ 真正的时间去哪了 | 算法 25 ms,读 2 × 10⁶ 个整数 245 ms(关同步 52 ms)—— ★ 读入是算法的 10 倍 |
| ★★ 补的那一节(第 39 章) | 同一道题的线段树版:行数 43 → 52,算法耗时 30 → 224 ms(7.46 倍),内存 3 → 15 MB;⚠ 而端到端只差 2.5 倍 —— 不减掉读入会得出相反结论 |
| ★★★ 那为什么还要学线段树 | 改成「区间最大值」:线段树动两处,树状数组的 sum(r) − sum(l−1) 整个塌掉(⚠ 除非题面保证只增不减,见 P1531) |