0题目原文(本地存了一份)
原题在洛谷上(页头有链接)。别人的网站不归我们管,打不开、改版、题号调整都可能发生。 所以每个解析页都把题面转录一份存在本地,跟着仓库一起进版本库。
转录自洛谷 P3375,日期见页头。两边不一致时信原站。
题目描述
给出两个字符串 s₁ 和 s₂,若 s₁ 的区间 [l, r] 子串与 s₂ 完全相同,则称 s₂ 在 s₁ 中出现了,
其出现位置为 l。现在请你求出 s₂ 在 s₁ 中所有出现的位置。
定义一个字符串 s 的 border 为 s 的一个非 s 本身的子串 t,
满足 t 既是 s 的前缀,又是 s 的后缀。
对于 s₂,你还需要求出对于其每个前缀 s' 的最长 border t' 的长度。
输入格式
第一行为一个字符串,即为 s₁。第二行为一个字符串,即为 s₂。
输出格式
首先输出若干行,每行一个整数,按从小到大的顺序输出 s₂ 在 s₁ 中出现的位置。
最后一行输出 |s₂| 个整数,第 i 个整数表示 s₂ 的长度为 i 的前缀的最长 border 长度。
数据规模与约定
本题采用多测试点捆绑测试,共有 4 个子任务。
- Subtask 0(30 分):
|s₁| ≤ 15,|s₂| ≤ 5。 - Subtask 1(40 分):
|s₁| ≤ 10⁴,|s₂| ≤ 10²。 - Subtask 2(30 分):无特殊约定。
- Subtask 3(0 分):Hack。
对于全部的测试点,保证 1 ≤ |s₁|, |s₂| ≤ 10⁶,s₁、s₂ 中均只含大写英文字母。
时限 1 秒,内存 524288 KB(512 MB)。
输入输出样例
输入
ABABABC
ABA
输出
1
3
0 0 1
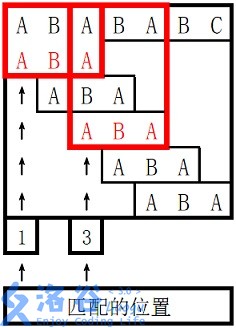
ABA 在 ABABABC 里出现在位置 1 和 3(★ 1 基,而且两次是重叠的)。
最后一行:ABA 的三个前缀 A / AB / ABA 的最长 border 长度分别是 0 / 0 / 1
(ABA 的 A 既是前缀也是后缀)。
这道题考什么:用 KMP 找出 s₂ 在 s₁ 中所有出现的位置(1 基),并输出 s₂ 每个前缀的最长 border 长度。正解是第 48 章的 KMP 模板。
最容易错的三处
- 位置照抄本书的 0 基:这道题的位置从 1 开始。
- border 那一行错位一格:题面要的是「第
i个前缀的最长 border」,直接输出nxt[0..m-1]就是对的。 - 用
endl一行一行打位置:答案全对,但顶格 10⁶ 行会把 100 倍余量吃到只剩 4 倍。
能 AC 的:p3375.cpp(KMP + 自己写输出缓冲)这一版能 AC。时限 1 秒。
下面每一步里灰色的「深入」块是折叠的:那是这些结论怎么实测出来的,第一遍可以跳过。
样例解释里的那张图(原站的图,本地存了一份):
1★★ 这一页的主线:会咬人的三处全在「约定」和「输出」上,一处都不在 KMP 上
这道题就是第 48 章正文那道题的原题 —— 算法一个字都不用再讲一遍
(next 怎么算、失配时 i 为什么不退、命中后为什么是 j = nxt[j-1],正文第 4~8 步全讲透了)。
★ 而第 48 章的题单在这道题后面挂了一句注解:
「⚠ 它的下标从 1 开始,next 的输出口径也和本书不同 —— 交之前先把两边的约定对一遍」。
这一页就是把那句话兑现成三个错法、一张输出账。 三处差别:
| 本书正文 | 这道题的题面 | |
|---|---|---|
| 出现位置 | 0 基 | ★ 1 基(样例是 1 和 3) |
| 位置怎么输出 | 先打次数,再一行打完 | ★ 一行一个,不打次数 |
| next 那一行 | p 的 next 数组 |
「每个前缀的最长 border」——★ 恰好就是 0 基的 nxt[0..m-1] |
⚠ 而真正会挂人的第四处,题面里一个字都没提:输出量。第 ④ 步整节在算这笔账。
// P3375【模板】KMP —— 正解:KMP + 自己写输出缓冲//// ★★ 这道题就是[第 48 章正文](/ch/48-kmp/)那道题的原题,**可它的约定和本书不一样**,//   三处都要对一遍(题单注解点的就是这件事)://   ① 出现位置是 **1 基**(题面:「其出现位置为 l」,样例里 ABA 在 ABABABC 中是 1 和 3)——//      本书正文一律 0 基 ⇒ 照抄要 **+1**(见 p3375Base.cpp);//   ② 第二行要的是「s2 的**每个前缀**的最长 border 长度」,一共 |s2| 个数//      —— 恰好就是 0 基 nxt[0..m-1],⚠ 但错位一格是最容易犯的(见 p3375Border.cpp);//   ③ 位置**按从小到大、一行一个**输出,不输出个数 —— 和正文那种「先打次数再打一行」完全不同。//// ⚠⚠ 而这道题真正的新关卡,正文一次都没量过:**输出**。//   顶格 s1 = 10⁶ 个 A、s2 = 一个 A ⇒ **10⁶ 行位置,约 6.9 MB**(见 p3375Out.cpp)。//   ⇒ `cout << x << endl` 会 flush 一百万次,当场 TLE(见 p3375Endl.cpp)。#include <cstdio>#include <cstring>using namespace std;
static const int MAXN = 1000006;static char s1[MAXN], s2[MAXN];static int nxt[MAXN];
static char obuf[1 << 22];                 // 4 MiB 输出缓冲:顶格输出约 6.9 MB,分两次冲出去static int opos = 0;static inline void flushOut() { fwrite(obuf, 1, (size_t)opos, stdout); opos = 0; }static inline void putc_(char c) { if (opos == (int)sizeof(obuf)) flushOut(); obuf[opos++] = c; }static inline void writeInt(int x, char tail) {    if (opos + 14 > (int)sizeof(obuf)) flushOut();    if (!x) obuf[opos++] = '0';    else { char t[12]; int k = 0; while (x) { t[k++] = (char)('0' + x % 10); x /= 10; }           while (k) obuf[opos++] = t[--k]; }    putc_(tail);}
int main() {    if (scanf("%s%s", s1, s2) != 2) return 0;    int n = (int)strlen(s1), m = (int)strlen(s2);
/* nxt[i] = s2[0..i] 的最长 border 长度(0 基)—— 正文第 5 步那五行 */ nxt[0] = 0; for (int i = 1, j = 0; i < m; i++) { while (j > 0 && s2[i] != s2[j]) j = nxt[j - 1]; if (s2[i] == s2[j]) j++; nxt[i] = j; } /* 匹配:i 一步都不退 */ for (int i = 0, j = 0; i < n; i++) { while (j > 0 && s1[i] != s2[j]) j = nxt[j - 1]; if (s1[i] == s2[j]) j++; if (j == m) { writeInt(i - m + 2, '\n'); // ★ +1 变 1 基,再 −m+1 回到起点 ⇒ i-m+2 j = nxt[j - 1]; // ⚠ 不能归零,否则漏掉重叠出现 } } for (int i = 0; i < m; i++) writeInt(nxt[i], i + 1 == m ? '\n' : ' '); flushOut(); return 0;}点「运行 ▶」看结果
题面的子任务分档就是出题人递过来的工具(第 43 章 P1313 那条):
- Subtask 0(30 分):
|s₁| ≤ 15⇒ 随便写; - Subtask 1(40 分):
|s₁| ≤ 10⁴、|s₂| ≤ 10²⇒ 朴素匹配最多 10⁶ 次比较,秒过。
⇒ 上面那份 p3375Brute.cpp 直接交上去就有 70 分,而它一行 KMP 都没有。
2⚠ 错法一:位置照抄本书的 0 基
本书正文(以及第 47 章 P1308)里,位置一律从 0 数;
而这道题的题面写的是「若 s₁ 的区间 [l, r] 子串与 s₂ 完全相同……其出现位置为 l」,
样例给的是 1 和 3。
⇒ 少一个 +1,每一个位置都小 1 —— 而它只在「真的有出现」时才现形:
一次都没出现时两边都只打 border 那一行,逐字节相同(那是能证的 0)。
// P3375 ✗ 错法一:位置照抄本书的 0 基,忘了题面是 1 基//// ⚠ 这是「把本书的写法搬到真题上」最典型的一跤:正文里位置一律从 0 数//   (第 47 章 P1308 也是「位置从 0 开始」),而这道题的题面写的是//   「若 s1 的区间 [l, r] 子串与 s2 完全相同……其出现位置为 l」—— 官方样例是 1 和 3。// ★ 触发条件干净得可以写成一句话:**只要 s2 在 s1 里出现过至少一次**。//   ⇒ 一次都没出现时它和正解逐字节相同(那一档是能证的 0)。#include <cstdio>#include <cstring>using namespace std;
static const int MAXN = 1000006;static char s1[MAXN], s2[MAXN];static int nxt[MAXN];
int main() { if (scanf("%s%s", s1, s2) != 2) return 0; int n = (int)strlen(s1), m = (int)strlen(s2); nxt[0] = 0; for (int i = 1, j = 0; i < m; i++) { while (j > 0 && s2[i] != s2[j]) j = nxt[j - 1]; if (s2[i] == s2[j]) j++; nxt[i] = j; } for (int i = 0, j = 0; i < n; i++) { while (j > 0 && s1[i] != s2[j]) j = nxt[j - 1]; if (s1[i] == s2[j]) j++; if (j == m) { printf("%d\n", i - m + 1); j = nxt[j - 1]; } // ⚠ 少了那个 +1 } for (int i = 0; i < m; i++) printf("%d%c", nxt[i], i + 1 == m ? '\n' : ' '); return 0;}点「运行 ▶」看结果
3⚠ 错法二:border 那一行错位一格
题面要的是:第 i 个整数 = 长度为 i 的前缀的最长 border 长度(i = 1..m)。
而 0 基的 nxt[i] 说的是「s₂[0..i] 的最长 border」,也就是长度 i+1 的前缀
⇒ 直接输出 nxt[0]、nxt[1]、…、nxt[m-1] 就是对的。
⚠ 可这一步所有人都会犹豫一下,一犹豫就写成「先补一个 0,再输出 nxt[0..m-2]」——整行右移一格。
★ 触发条件:移位之后那一行和原来不同
(⇒ nxt 全是 0 时它反而对 —— 而那正是顺手写的随机数据的常态,见第 ⑤ 步档 0 的 27 / 300)。
4★★★ 第四处题面没提的:输出量 —— 顶格 6.89 MB、10⁶ 行
// P3375 —— 「输出」那一关到底值多少:五种打法,同一份顶格数据各跑一遍。//   ./p3375Out <打法> <输出文件>      打法 ∈ endl / nl / nosync / printf / buf//   报告打在标准输出上,**正文那 6.9 MB 写进 <输出文件>**。//// ⚠⚠ 为什么一定要写进**文件**,而不是让它打到管道里(2026-09-07 在 [P1308](/sol/p1308/) 上撞出来的)://   管道那一头是谁、读得多快,**会被一起量进来**。评测机做的是「stdout 重定向到一个文件」,//   所以这里也用 `freopen`,量完再 `dup2` 把 fd 1 换回来打报告。//   ⇒ ★★ **量什么都要先问一句「这个数里有没有别人的份」。**//// ★ 顶格形状挑的是「输出最多」的那一种:s1 = 10⁶ 个 A、s2 = 一个 A//   ⇒ **每一个位置都命中**,要打 10⁶ 行。#include <bits/stdc++.h>#include <unistd.h>using namespace std;
static const int N = 1000000;static vector<int> pos;                     // 所有命中位置(1 基)static char obuf[1 << 22];static int opos = 0;static inline void flushOut() { fwrite(obuf, 1, (size_t)opos, stdout); opos = 0; }static inline void writeInt(int x) {    if (opos + 14 > (int)sizeof(obuf)) flushOut();    if (!x) obuf[opos++] = '0';    else { char t[12]; int k = 0; while (x) { t[k++] = (char)('0' + x % 10); x /= 10; }           while (k) obuf[opos++] = t[--k]; }    obuf[opos++] = '\n';}
int main(int argc, char** argv) {    string mode = argc > 1 ? argv[1] : "buf";    const char* out = argc > 2 ? argv[2] : "/dev/null";
    /* 顶格:s1 全是 A、s2 只有一个 A ⇒ 命中 10⁶ 次(KMP 那部分这里不是重点,直接列出位置)*/    pos.reserve(N);    for (int i = 1; i <= N; i++) pos.push_back(i);
    int saved = dup(1);    if (!freopen(out, "w", stdout)) return 1;    auto t0 = chrono::steady_clock::now();    if (mode == "endl") {        for (int p : pos) cout << p << endl;                 // ⚠ 每行 flush    } else if (mode == "nl") {        for (int p : pos) cout << p << '\n';    } else if (mode == "nosync") {        ios::sync_with_stdio(false);        cout.tie(nullptr);        for (int p : pos) cout << p << '\n';    } else if (mode == "printf") {        for (int p : pos) printf("%d\n", p);    } else {        for (int p : pos) writeInt(p);        flushOut();    }    cout.flush();    fflush(stdout);    auto t1 = chrono::steady_clock::now();    double ms = chrono::duration<double, milli>(t1 - t0).count();    long long bytes = ftell(stdout);    dup2(saved, 1);    close(saved);    clearerr(stdout);
printf("%s,%.1f,%lld\n", mode.c_str(), ms, bytes); return 0;}点「运行 ▶」看结果
深入:顶格 6.89 MB 的五种输出打法与 endl 的代价(进阶)
输出量最大的形状不是「串最长」,是「命中最多」:
   s1 = 10⁶ 个 A          s2 = 一个 A
   ⇒ 每一个位置都命中 ⇒ 要打 10⁶ 行位置
实测输出 6 888 896 字节(6.57 MiB) —— 而题面对输出量只字未提。
五种打法(A 机:WSL2 6.18 / 8 核 / 8 GB,2026-09-08,独占;同一份 10⁶ 行,各跑 3 次取中位数):
| 打法 | 耗时 | 相对最快 |
|---|---|---|
cout << x << endl |
247 ms | 28 倍 |
cout << x << '\n' |
28 ms | 3.2 倍 |
关同步 + '\n' |
25 ms | 2.8 倍 |
printf("%d\n", x) |
30 ms | 3.4 倍 |
★ 自己写 4 MiB 缓冲 + fwrite |
★ 8.8 ms | 1.0 |
★★ endl → '\n' 值 8.8 倍 —— 和第 41 章 P3383 量到的一模一样(那页也是 8.8 倍)。
⇒ endl 的问题从来不是换行,是每一行都 flush 一次,这里是一百万次。
★ 而关同步在输出这一侧几乎不值钱(28 → 25 ms,1.1 倍)——
⚠ 对照读入那一侧的 6.2 倍(P3383):并排放着的两条建议,分量差一个数量级。
端到端跑一遍顶格(读 1 MB + KMP + 写 6.89 MB):
| 版本 | 顶格耗时 | 时限 1 秒 |
|---|---|---|
| ★ 正解 | 0.01 秒 | 余量 100 倍 |
✗ endl 版 |
0.25 秒 | ⚠ 它能过,余量只剩 4 倍 |
⇒ ★★★ 「肯定超时」又一次被打回(第 41 章、第 42 章、 第 46 章 都中过)—— 正确的说法是:它不是过不了,是把 100 倍的余量吃到只剩 4 倍。 ⚠ 而这 4 倍是在本机量的,评测机更慢、输出还可能过管道 —— 赌不起。
★★ 顺带一条对拍纪律:endl 版和正解的输出逐字节相同,
四档 1200 轮一次都没被抓到(下一步那张表的最后一列全是 0)。
⇒ 第 48 章第 9 步那条在这儿换了个主语又成立一次:
只影响速度、不影响答案的写法,对拍原理上看不见 —— 这一次它长在输出上。
5★ 对拍:八格「触发 ≡ 抓获」,而顺手写的那一档在验零
// P3375 的生成器:./p3375Gen 种子 [档位]//// ★ 三个待测版本各靠什么现形://   · p3375Base(位置忘了 +1)  → **s2 在 s1 里至少出现一次**;//   · p3375Border(border 行右移一格)→ **移位之后那一行和原来不同**;//   · p3375Endl(用 endl 打)   → ⚠ **答案永远对,对拍原理上抓不到**(只能量时间)。//// 档位://   0  ★ 顺手写的:26 个大写字母随机,|s1| = 20~40、|s2| = 2~5//      ⚠ 这一档多半**一次都不出现**(随机 26 个字母里撞上一个长度 3 的串,概率约 1/17576)//   1  ⚠ 保证出现:先摇 s2,再把它塞进 s1 的随机位置(1~3 处)//   2  ⚠ 字母表压到 2 个(A / B)⇒ border 非零、重叠出现满地都是//   3  ★ 最终档:小字母表 + 周期串(s2 = 一小段重复若干次)//// ⚠ rng() 一律先落到具名变量再传参([第 24 章 P1776](/sol/p1776/) 那一跤)。#include <bits/stdc++.h>using namespace std;
int main(int argc, char** argv) {    unsigned seed = argc > 1 ? (unsigned)atoi(argv[1]) : 1;    int mode = argc > 2 ? atoi(argv[2]) : 0;    mt19937 rng(seed * 1000003u + 20260908u);
    int alpha = (mode >= 2) ? 2 : 26;    auto pick = [&]() { unsigned r = rng() % (unsigned)alpha; return (char)('A' + r); };
    unsigned r1 = rng() % 21u;    int n = 20 + (int)r1;    unsigned r2 = rng() % 4u;    int m = 2 + (int)r2;
    string b;    if (mode == 3) {                                   // 周期串:一小段重复若干次        unsigned rp = rng() % 3u;        int p = 1 + (int)rp;        unsigned rk = rng() % 3u;        int k = 2 + (int)rk;        string unit;        for (int i = 0; i < p; i++) unit.push_back(pick());        for (int i = 0; i < k; i++) b += unit;        m = (int)b.size();    } else {        for (int i = 0; i < m; i++) b.push_back(pick());    }
string a; for (int i = 0; i < n; i++) a.push_back(pick()); if (mode >= 1) { // 保证出现:塞 1~3 处 unsigned rc = rng() % 3u; int times = 1 + (int)rc; for (int t = 0; t < times && m <= n; t++) { unsigned rp = rng() % (unsigned)(n - m + 1); for (int k = 0; k < m; k++) a[(size_t)rp + (size_t)k] = b[(size_t)k]; } } printf("%s\n%s\n", a.c_str(), b.c_str()); return 0;}点「运行 ▶」看结果
深入:四档对拍表与三条结论(进阶)
四档 × 300 轮(正解 vs 朴素参照物:1200 轮 0 组不一致):
| 档位 | 有出现的轮数 | ✗ 位置 0 基 | ✗ border 右移 | ✗ endl |
|---|---|---|---|---|
| 0 ★ 顺手写的(26 个大写字母随机) | ⚠ 8 | 8 | 27 | ★ 0 |
| 1 ⚠ 保证 s₂ 出现(塞进 s₁ 里) | 300 | 300 | 27 | ★ 0 |
| 2 ⚠ 字母表压到 2 个 | 300 | 300 | 247 | ★ 0 |
| 3 ★ 最终档(小字母表 + 周期串) | 300 | 300 | 300 | ★ 0 |
-
★★★ 顺手写的那一档在验零 —— 26 个大写字母里随机造一个长度 2~5 的
s₂, 300 轮里只有 8 轮它真的出现在s₁里(一个长度 3 的串撞上的概率约 1/17576)。 ⇒ 另外 292 轮所有版本一起只打 border 那一行,对拍记「通过」。 ⇒ 第 47 章 P1071 那条刚立的规矩,换一道题又成立一次: 先算一句「正解会不会答出东西来」,低了就反着造。 -
★★ 两个「约定」错法的触发条件方向相反 —— 「位置 0 基」要的是有出现 (小字母表一抓一个准),「border 右移」要的是
nxt不全为 0 (随机 26 个字母时nxt几乎全是 0 ⇒ 只有 27 / 300)。 ⇒ ★ 一个旋钮(字母表大小)同时把两列往上推,而它们原来卡在不同的地方。 -
★ 八格「触发 ≡ 抓获」一个不差(前两列),而第三列是结构性的全 0:
endl版的答案永远对。
6★ 官方那唯一一组样例:两个「约定」错法全打死
| ✗ 位置 0 基 | ✗ border 右移 | ✗ endl |
|
|---|---|---|---|
官方样例 ABABABC / ABA |
★ 死(打出 0 和 2) | ★ 死(打出 0 0 0) |
放过(答案相同) |
★ 本书连着量了十几道题的那条规律 —— 官方样例是个「一测就死」的过滤器:它挡住「每一组都错」的,放过「偶尔才错」的 —— 在这一页是正面成立的:两个约定错法每一组都错,所以一交样例就死。
⚠ 而它对第三个错法(endl)完全无能为力,因为那个错法的答案是对的
(第 20 章 P5019 那条:样例这个过滤器筛的是「答案错」)。
⚠⚠ 外加一条只有把两页放在一起才看得见的:
这道题的官方样例输出,最后一行末尾是带一个空格的(0 0 1 )——
也就是说它的评测机忽略行末空白。
而第 47 章 P1598 的题面把「任何一行末尾不要打印多余空格」写了两遍。
⇒ ★★ 「行末空格要不要紧」不是一个能背的经验,是每道题各自的规定 ——
⚠ 但我们自己的对拍仍然要逐字节比(P1598 那页量过:一 strip,一整类 bug 当场消失)。
7★ 哪一版就已经能过了
| 版本 | 结果 | 说明 |
|---|---|---|
★ p3375.cpp |
AC | 顶格 0.01 秒 / 时限 1 秒,余量 100 倍 |
★ p3375Brute.cpp |
⚠ 70 分 | Subtask 0 + 1(10⁴ × 10² = 10⁶ 次比较) |
| ✗ 位置 0 基 | WA | 样例就死 |
| ✗ border 右移 | WA | 样例就死 |
✗ endl 版 |
⚠ 能过(0.25 秒) | 余量从 100 倍掉到 4 倍 —— 赌不起 |
⇒ ★★ 一句话带走:模板题的模板部分是最不容易错的那部分。 这一页的三个坑(1 基 / border 口径 / 输出量), 一个来自「把别处的写法搬过来」,一个来自「题面那句话读了两遍还是没读准」, 一个来自「题面根本没提」—— ⇒ 交模板题之前,把输入输出格式那两段逐字读一遍, 再乘一句「最多要打多少字节」。
8★★★ 补一节(第 49 章题单点名的):用哈希再写一遍,会发现只写得完一半
深入:用哈希再写一遍:第一问纯哈希,第二问借 KMP 那句均摊(进阶)
第 49 章(字符串哈希)的题单里又列了这道题,注解是:
「第 48 章那道题。用哈希再写一遍,体会一下『同一道题两条路』。」
★ 而这一页是 2026-09-08 写的,那时讲的全是 KMP —— 拿「哈希 / hash」去 grep 这一页,
0 处命中。⇒ 本书那条「命中登记表 ≠ 不用写」的规矩第八次成立
(前七次是 P1776 / P1177 / P2367 / P3374 / P1044 / P1226 / P1308),
所以这儿补两节。
⚠⚠ 而补出来的结论并不是「两条路都行」——是 哈希只写得完这道题的一半。
第一问是「找出 s₂ 在 s₁ 中所有出现的位置」,哈希做起来一点不费劲:
给 s₁ 做一份前缀哈希、把 s₂ 整体的哈希算出来,然后每个起点比一个数。
   for (int i = 0; i + m <= n; i++)
       if (sub(i, m) == hash(s2)) 打出 i + 1;     // ★ 1 基
⇒ O(n + m),和 KMP 一个量级。这一半是「同一道题两条路」的正面例子。
第二问要的是「s₂ 的每个前缀的最长 border」。
顺着「哈希能 O(1) 比任意两段」的思路,第一版一定是:
对每个前缀 i:从长到短试 k = i, i−1, …, 1,第一个「前 k 位 == 后 k 位」的就是答案⚠ 它完全正确,只是 O(m²) —— 顶格 m = 10⁶ ⇒ 5×10¹¹ 次,必挂。
★★★ 要把它压回 O(m),只能加一句话:
nxt[i] ≤ nxt[i−1] + 1(长度i+1的前缀的 border,去掉最后一个字符还是长度i的前缀的 border)
⇒ 于是 k 每一步最多涨 1、只会往下掉 ⇒ 总下降次数 ≤ 总上升次数 ≤ m ⇒ 均摊 O(m)。
⚠⚠ 而那句话正是 KMP 的全部内容。
这一版的真实身份是:把 KMP 里「跳 nxt[j−1]」那一步,换成「k--、拿哈希验一下」
—— 同一个均摊论证,换了个更贵的验法。
⇒ ★★★ 一句话:哈希替得了 KMP 的前半场,替不了它的后半场; 而要替后半场,你得先把 KMP 那句话自己想出来。
// P3375 —— ★ [第 49 章](/ch/49-hash/)的题单点名要「用哈希再写一遍」,这就是那一遍。//// ★★ 第一问(找出现位置)哈希做起来一点不费劲,而且和 KMP 一样是 O(n)://   给 s1 做一份前缀哈希,把 s2 整体的哈希算出来,然后**每个起点比一个数**。//   ⇒ 这一半是「同一道题两条路」的正面例子。//// ⚠⚠ 而第二问(每个前缀的最长 border)**哈希单独做不下来**。//   顺着「哈希能 O(1) 比任意两段」的思路,第一版一定是//     「对每个前缀 i,从长到短逐个试 k = i−1, i−2, …」——//   那是 O(m²)(见 p3375HashAll.cpp,顶格 5×10¹¹ 次,必挂)。//// ★★★ 要把它压回 O(m),只能加一句话:**nxt[i] ≤ nxt[i−1] + 1**//   (长度 i+1 的前缀的 border,去掉最后一个字符还是长度 i 的前缀的 border)//   ⇒ 于是 k 每一步最多涨 1、只会往下掉 ⇒ 总的下降次数 ≤ 总的上升次数 ≤ m ⇒ 均摊 O(m)。//   ⚠⚠ **而那句话正是 KMP 的全部内容。**//   ⇒ 所以这一版的真实身份是:**把 KMP 里那句「跳 nxt[j−1]」换成「k−−、拿哈希验一下」**//     —— 同一个均摊论证,换了个更贵的验法(每次验要两次乘法、两次取模)。//// ⇒ ★★★ 一句话:**哈希替得了 KMP 的前半场,替不了它的后半场;//   而要替后半场,你得先把 KMP 那句话自己想出来。**#include <cstdio>#include <cstring>using namespace std;
typedef long long ll;static const int MAXN = 1000006;static const ll MOD1 = 1000000007, MOD2 = 998244353, B1 = 131, B2 = 13331;static char s1[MAXN], s2[MAXN];static ll h1[MAXN], h2[MAXN], g1[MAXN], g2[MAXN], p1[MAXN], p2[MAXN];static int nxt[MAXN];
static char obuf[1 << 22];static int opos = 0;static inline void flushOut() { fwrite(obuf, 1, (size_t)opos, stdout); opos = 0; }static inline void writeInt(int x, char tail) {    if (opos + 14 > (int)sizeof(obuf)) flushOut();    if (!x) obuf[opos++] = '0';    else { char t[12]; int k = 0; while (x) { t[k++] = (char)('0' + x % 10); x /= 10; }           while (k) obuf[opos++] = t[--k]; }    obuf[opos++] = tail;}
int main() {    if (scanf("%s%s", s1, s2) != 2) return 0;    int n = (int)strlen(s1), m = (int)strlen(s2);    int mx = n > m ? n : m;    p1[0] = p2[0] = 1;    for (int i = 1; i <= mx; i++) { p1[i] = p1[i - 1] * B1 % MOD1; p2[i] = p2[i - 1] * B2 % MOD2; }    for (int i = 0; i < n; i++) {        ll c = s1[i] - 'A' + 1;        h1[i + 1] = (h1[i] * B1 + c) % MOD1;        h2[i + 1] = (h2[i] * B2 + c) % MOD2;    }    for (int i = 0; i < m; i++) {        ll c = s2[i] - 'A' + 1;        g1[i + 1] = (g1[i] * B1 + c) % MOD1;        g2[i + 1] = (g2[i] * B2 + c) % MOD2;    }    /* [l, l+len) 的哈希(0 基),两个模数各一份 */#define SUB(h, p, MOD, l, len) (((h[(l) + (len)] - h[l] * p[len]) % MOD + MOD) % MOD)
    /* ① 第一问:每个起点比一个数 —— O(n) */    for (int i = 0; i + m <= n; i++)        if (SUB(h1, p1, MOD1, i, m) == g1[m] && SUB(h2, p2, MOD2, i, m) == g2[m])            writeInt(i + 1, '\n');                       // ★ 1 基
/* ② 第二问:k 最多涨 1、只会往下掉 ⇒ 均摊 O(m)。⚠ 这句话就是 KMP */ nxt[0] = 0; for (int i = 1, k = 0; i < m; i++) { k++; // ★ 上界:nxt[i] ≤ nxt[i−1] + 1(而它 ≤ i 自动成立) while (k > 0 && !(SUB(g1, p1, MOD1, 0, k) == SUB(g1, p1, MOD1, i - k + 1, k) && SUB(g2, p2, MOD2, 0, k) == SUB(g2, p2, MOD2, i - k + 1, k))) k--; nxt[i] = k; } for (int i = 0; i < m; i++) writeInt(nxt[i], i + 1 == m ? '\n' : ' '); flushOut(); return 0;}点「运行 ▶」看结果
9★★ 把两条路量出来:一次「两把尺子打架」,一次反过来的「顶格 ≠ 最坏」
// P3375 —— 「同一道题两条路」到底差在哪儿:把 KMP 和哈希放在一起量。//// ★ 第一问(找出现位置)两条路都是 O(n),比的是**常数**://   KMP 每个位置做一次字符比较;哈希每个位置做一次「两个 64 位数相等吗」,//   而建表那一遍每个字符要两次乘法 + 两次取模。//// ★★★ 第二问(每个前缀的最长 border)才是重点:**哈希单独做不下来**。//   三条路,都在这儿量://     ① KMP           —— 跳 nxt 链,均摊 O(m)//     ② 哈希 + 均摊  —— 用「nxt[i] ≤ nxt[i−1] + 1」,同样均摊 O(m)//                        ⚠ **而那句话就是 KMP**//     ③ 纯哈希        —— 每个前缀从长到短逐个试,O(m²)//   ⚠⚠ 而 ③ 的最坏形状是**随机串**(nxt 几乎全 0 ⇒ 每个 i 都要试到底),//     全 `A` 的串反而是它的最好情形 —— 和本书大多数「顶格 ≠ 最坏」正好反过来。//// 用法:./p3375HashCount [cnt|time|table|csv]#include <bits/stdc++.h>using namespace std;
static string padDisp(const string& s, int width) {    int disp = 0;    for (unsigned char c : s) { if ((c & 0xC0) == 0x80) continue; disp += (c < 0x80) ? 1 : 2; }    return s + string(max(0, width - disp), ' ');}static string padLeft(const string& s, int width) {    int disp = 0;    for (unsigned char c : s) { if ((c & 0xC0) == 0x80) continue; disp += (c < 0x80) ? 1 : 2; }    return string(max(0, width - disp), ' ') + s;}
typedef long long ll;static const ll MOD1 = 1000000007, MOD2 = 998244353, B1 = 131, B2 = 13331;static long long ops = 0;
/* ① KMP 的 nxt:数「比较了多少次字符」 */static vector<int> kmpNxt(const string& s) {    int m = (int)s.size();    vector<int> nxt(m, 0);    for (int i = 1, j = 0; i < m; i++) {        while (j > 0 && (++ops, s[i] != s[j])) j = nxt[j - 1];        if ((++ops, s[i] == s[j])) j++;        nxt[i] = j;    }    return nxt;}
struct H {    vector<ll> h1, h2, p1, p2;    void build(const string& s) {        int n = (int)s.size();        h1.assign(n + 1, 0); h2.assign(n + 1, 0); p1.assign(n + 1, 1); p2.assign(n + 1, 1);        for (int i = 0; i < n; i++) {            ll c = s[i] - 'A' + 1;            h1[i + 1] = (h1[i] * B1 + c) % MOD1;            h2[i + 1] = (h2[i] * B2 + c) % MOD2;            p1[i + 1] = p1[i] * B1 % MOD1;            p2[i + 1] = p2[i] * B2 % MOD2;        }    }    bool eq(int l1, int l2, int len) const {        ll a = ((h1[l1 + len] - h1[l1] * p1[len]) % MOD1 + MOD1) % MOD1;        ll b = ((h1[l2 + len] - h1[l2] * p1[len]) % MOD1 + MOD1) % MOD1;        if (a != b) return false;        ll c = ((h2[l1 + len] - h2[l1] * p2[len]) % MOD2 + MOD2) % MOD2;        ll d = ((h2[l2 + len] - h2[l2] * p2[len]) % MOD2 + MOD2) % MOD2;        return c == d;    }};
/* ② 哈希 + 均摊:数「做了多少次段比较」 */static vector<int> hashAmort(const string& s, const H& h) {    int m = (int)s.size();    vector<int> nxt(m, 0);    for (int i = 1, k = 0; i < m; i++) {        k++;        while (k > 0 && (++ops, !h.eq(0, i - k + 1, k))) k--;        nxt[i] = k;    }    return nxt;}
/* ③ 纯哈希:每个前缀从长到短逐个试 */static vector<int> hashAll(const string& s, const H& h) {    int m = (int)s.size();    vector<int> nxt(m, 0);    for (int i = 1; i < m; i++) {        int k = i;        while (k > 0 && (++ops, !h.eq(0, i - k + 1, k))) k--;        nxt[i] = k;    }    return nxt;}
int main(int argc, char** argv) {    string mode = argc > 1 ? argv[1] : "table";    bool csv = (mode == "csv");
    /* ---------- 第二问的次数表 ---------- */    const int MS[3] = { 500, 2000, 8000 };    const char* SHAPE[2] = { "★ 26 个大写字母随机(nxt 几乎全 0)", "全是 A(nxt = 0,1,2,…)" };    long long tab[2][3][3];    int allSame = 1;    for (int sh = 0; sh < 2; sh++)        for (int k = 0; k < 3; k++) {            int m = MS[k];            string s(m, 'A');            mt19937 rg(20260909u + sh * 13 + k);            if (sh == 0) for (int i = 0; i < m; i++) s[i] = (char)('A' + rg() % 26);            H h; h.build(s);            ops = 0; vector<int> a = kmpNxt(s);      tab[sh][k][0] = ops;            ops = 0; vector<int> b = hashAmort(s, h); tab[sh][k][1] = ops;            ops = 0; vector<int> c = hashAll(s, h);   tab[sh][k][2] = ops;            if (a != b || a != c) allSame = 0;        }
    if (mode == "cnt" || mode == "table") {        printf("★ 第二问(每个前缀的最长 border):三条路各做多少次比较\n\n");        for (int sh = 0; sh < 2; sh++) {            printf("  %s\n", SHAPE[sh]);            printf("    %-8s %s %s %s\n", "|s2|", padLeft("① KMP", 14).c_str(),                   padLeft("② 哈希+均摊", 16).c_str(), padLeft("③ 纯哈希 O(m²)", 18).c_str());            for (int k = 0; k < 3; k++)                printf("    %-8d %14lld %16lld %18lld\n", MS[k],                       tab[sh][k][0], tab[sh][k][1], tab[sh][k][2]);            printf("    m 每翻 4 倍,③ 这一列 ×%.1f、×%.1f\n\n",                   (double)tab[sh][1][2] / tab[sh][0][2], (double)tab[sh][2][2] / tab[sh][1][2]);        }        printf("    三条路算出来的 nxt 数组完全一致:%s\n\n", allSame ? "是" : "否");    }
    /* ---------- 顶格第一问的秒表 ---------- */    double tKmp = 0, tHash = 0;    long long cKmp = 0, cHash = 0;    {        const int N = 1000000, M = 1000;        string s1(N, 'A'), s2(M, 'A');        mt19937 rg(20260909u);        for (int i = 0; i < N; i++) s1[i] = (char)('A' + rg() % 26);        for (int i = 0; i < M; i++) s2[i] = s1[12345 + i];      // ★ 保证真的出现过一次        double v[3];        for (int r = 0; r < 3; r++) {            auto t0 = chrono::steady_clock::now();            vector<int> nxt = kmpNxt(s2);            ops = 0;            volatile int hit = 0;            for (int i = 0, j = 0; i < N; i++) {                while (j > 0 && (++ops, s1[i] != s2[j])) j = nxt[j - 1];                if ((++ops, s1[i] == s2[j])) j++;                if (j == M) { hit++; j = nxt[j - 1]; }            }            cKmp = ops;            v[r] = chrono::duration<double, milli>(chrono::steady_clock::now() - t0).count();        }        sort(v, v + 3); tKmp = v[1];        for (int r = 0; r < 3; r++) {            auto t0 = chrono::steady_clock::now();            H a, b;            a.build(s1); b.build(s2);            ops = 0;            volatile int hit = 0;            ll g1 = b.h1[M], g2 = b.h2[M];            for (int i = 0; i + M <= N; i++) {                ops++;                ll x = ((a.h1[i + M] - a.h1[i] * a.p1[M]) % MOD1 + MOD1) % MOD1;                if (x != g1) continue;                ll y = ((a.h2[i + M] - a.h2[i] * a.p2[M]) % MOD2 + MOD2) % MOD2;                if (y == g2) hit++;            }            cHash = ops;            v[r] = chrono::duration<double, milli>(chrono::steady_clock::now() - t0).count();        }        sort(v, v + 3); tHash = v[1];    }
    if (mode == "time" || mode == "table") {        printf("★ 第一问(找出现位置)顶格 |s1| = 10⁶、|s2| = 10³(3 次取中位数)\n\n");        printf("    %s %14s %16s\n", padDisp("", 20).c_str(), "比较次数", "毫秒");        printf("    %s %14lld %14.1f ms\n", padDisp("① KMP", 20).c_str(), cKmp, tKmp);        printf("    %s %14lld %14.1f ms\n", padDisp("② 哈希", 20).c_str(), cHash, tHash);        printf("\n    ⇒ ★★ 两把尺子又打架:哈希的**比较次数更少**(%lld < %lld),"               "秒表却慢 %.1f 倍\n", cHash, cKmp, tHash / tKmp);        printf("       —— 因为哈希那 %d 个字符每一个都要两次乘法 + 两次取模,而 KMP 只是比一个字节\n", 1000000);        printf("    ⇒ 两条路都是 O(n)、都能过(时限 1 秒),可**哈希在第一问上没有任何便宜可占**\n");        printf("    ⚠ 而单模数在这道题上撞的概率:每次提交约 (n − m + 1) / 10⁹ = %.4f%%\n",               100.0 * (1000000 - 1000 + 1) / 1e9);    }
if (csv) { for (int sh = 0; sh < 2; sh++) for (int k = 0; k < 3; k++) printf("cnt%d_%d,%lld %lld %lld\n", sh, MS[k], tab[sh][k][0], tab[sh][k][1], tab[sh][k][2]); for (int sh = 0; sh < 2; sh++) printf("grow%d,%.1f %.1f\n", sh, (double)tab[sh][1][2] / tab[sh][0][2], (double)tab[sh][2][2] / tab[sh][1][2]); printf("allSame,%d\ncKmp,%lld\ncHash,%lld\ntKmp,%.1f\ntHash,%.1f\n", allSame, cKmp, cHash, tKmp, tHash); } return 0;}点「运行 ▶」看结果
深入:KMP ↔ 哈希:次数表与秒表(进阶)
| 模式串长度 | ① KMP | ② 哈希 + 均摊 | ③ 纯哈希 O(m²) |
|---|---|---|---|
26 个大写字母随机(nxt 几乎全 0) |
|||
| 500 | 521 | 521 | 124 748 |
| 2000 | 2 074 | 2 074 | 1 998 998 |
| 8000 | 8 326 | 8 326 | 31 995 990 |
m 每翻 4 倍 |
×4 | ×4 | ★ ×16.0 |
全是 A(nxt = 0,1,2,…) |
|||
| 500 | 997 | 499 | ★ 499 |
| 2000 | 3 997 | 1 999 | ★ 1 999 |
| 8000 | 15 997 | 7 999 | ★ 7 999 |
⇒ ★★★ 纯哈希那一版的最坏形状是「26 个字母随机」,不是「全一样的串」 ——
全 A 时每个前缀第一次试 k = i 就命中,每个 i 只试 1 次,它是 O(m);
随机串上 nxt 几乎全是 0,每个 i 都要一路试到 1,正好是最坏。
⇒ ★★ 于是「顺手造一组顶格数据」在这道题上恰好造出了最坏情形 ——
和本书大多数「顶格 ≠ 最坏」的例子正好反过来
(那些例子里顺手造的顶格总是太软)。
⚠ 而顶格 m = 10⁶ 的随机串 ⇒ 5×10¹¹ 次,它是这道题上唯一一个真会 TLE 的写法。
★ 三条路算出来的 nxt 数组完全一致(六组数据逐个比)。
顶格「文本 10⁶ 个字符、模式串 10³ 个字符」(3 次取中位数,A 机 · WSL2 · 2026-09-09 · 独占):
| 比较次数 | 毫秒 | |
|---|---|---|
| ① KMP | 1 041 050 | ★ 0.7 ms |
| ② 哈希 | ★ 999 001 | 14.1 ms |
⇒ ★★ 两把尺子又打架(第 16 章 P1074 那条): 哈希的次数更少,秒表却慢 19.3 倍 —— 因为哈希那 10⁶ 个字符每一个都要两次乘法 + 两次取模,而 KMP 只是比一个字节。
⚠ 但两条路都是 O(n)、都过得去(时限 1 秒)
⇒ 正确的说法是:哈希在第一问上没有任何便宜可占,不是「它不行」。
★ 顺带把这道题的赌注也算一遍:单模数在这道题上撞的概率约
(n − m + 1) / 10⁹ = 0.0999% —— 一千次提交撞一次。
⇒ 而这道题有 Hack 子任务(Subtask 3),出题人是可以照着模数造数据的。
| 第一问(找出现位置) | 第二问(每个前缀的最长 border) | |
|---|---|---|
| KMP | O(n),0.7 ms |
O(m),一句 j = nxt[j−1] |
| 哈希 | O(n),14.1 ms(慢 19 倍,但够) |
⚠ 要么 O(m²) 挂掉,要么把 KMP 那句话再想一遍 |
⇒ ★★★ 一句话带走:「同一道题两条路」有时只是半条路。
而这一页给出的判据很具体:哈希擅长「验一个你已经猜到的答案」,
不擅长「找出那个答案是几」 —— 第二问要的正是后者,
所以它必须借 nxt[i] ≤ nxt[i−1] + 1 把候选压到均摊 O(1) 个。
(同题单的 P1368 是正面的例子:那道题的候选只有 n 个起点、
每次要验的是「哪一位分出高下」⇒ 二分 + 哈希直接就成了。)